El retorno de la representación del conocimiento
Se argumenta que la representación del conocimiento que parecía perdida en la IA, parece retornar con fuerza en aplicaciones como los agentes.


Se argumenta que la representación del conocimiento que parecía perdida en la IA, parece retornar con fuerza en aplicaciones como los agentes.
Para cerrar la serie sobre la obtención de modelos razonadores a partir de modelos de lenguaje, hablamos del destilado (‘distillation’).
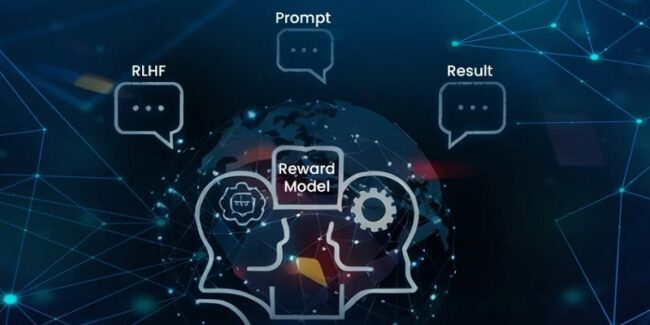
Describimos el aprendizaje por refuerzo con feedback humano (RLHF) como un mecanismo para convertir un modelo de lenguaje en modelo razonador.
Comentamos la estrategia de aprendizaje por refuerzo con recompensas verificables (RLVR) como forma de entrenamiento para modelos razonadores.
Presentamos la técnica de auto-refinamiento, una forma de conseguir que un gran modelo de lenguaje actúe como razonador.
Presentamos dos técnicas de prompting que ayudan a que un modelo razone, aunque supongan mayor coste computacional.
Comentamos las tres estrategias básicas para hacer que hacemos que un modelo razone, pasando de la generación de texto a planes.
Se especula sobre el sentido de una geometría y una cinemática, en grandes modelos de lenguaje, con trayectorias, velocidades, etc
Se muestran algunas grietas en el determinismo de los algoritmos generativos y LLM que hasta ahora habíamos observado.
Hablo de los parámetros que gobiernan la aleatoriedad en grandes modelos de lenguaje y relaciones con el eventual determinismo.