El retorno de la representación del conocimiento
Se argumenta que la representación del conocimiento que parecía perdida en la IA, parece retornar con fuerza en aplicaciones como los agentes.


Tecnologías digitales. Tendencias tecnológicas. Estándares. Personajes.
Se argumenta que la representación del conocimiento que parecía perdida en la IA, parece retornar con fuerza en aplicaciones como los agentes.
Para cerrar la serie sobre la obtención de modelos razonadores a partir de modelos de lenguaje, hablamos del destilado (‘distillation’).
Especulamos con la idea de que las aplicaciones basadas en LLMs, sobre todo agentes, utilicen mecanismos similares a la delegación cognitiva
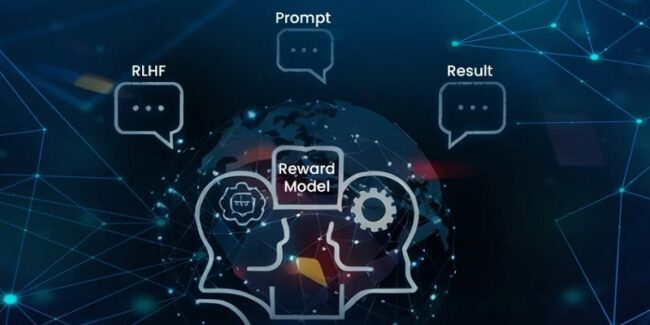
Describimos el aprendizaje por refuerzo con feedback humano (RLHF) como un mecanismo para convertir un modelo de lenguaje en modelo razonador.
Comentamos la estrategia de aprendizaje por refuerzo con recompensas verificables (RLVR) como forma de entrenamiento para modelos razonadores.
Identifico un fenómeno, ‘el dilema del inteligente’ que puede retrasar la adopción de la IA por parte de personas talentosas.
Presentamos la técnica de auto-refinamiento, una forma de conseguir que un gran modelo de lenguaje actúe como razonador.
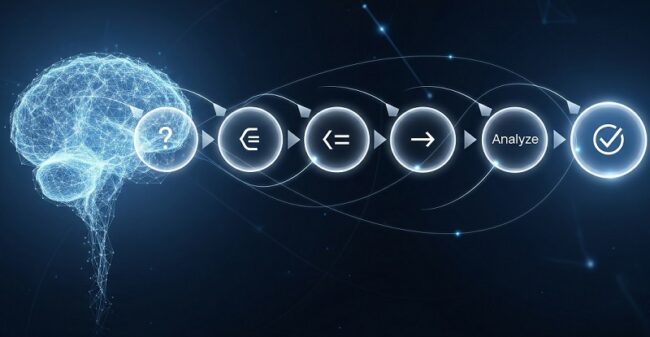
Presentamos dos técnicas de prompting que ayudan a que un modelo razone, aunque supongan mayor coste computacional.
Comentamos las tres estrategias básicas para hacer que hacemos que un modelo razone, pasando de la generación de texto a planes.
Expreso mi opinión sobre la reciente publicación de Darío Amodei sobre los riesgos de los modelos frontera y cómo afrontarlos.