Cómo hacemos que un modelo razone (IV): aprendizaje por refuerzo basado en recompensas verificables (RLVR)
Comentamos la estrategia de aprendizaje por refuerzo con recompensas verificables (RLVR) como forma de entrenamiento para modelos razonadores.


Comentamos la estrategia de aprendizaje por refuerzo con recompensas verificables (RLVR) como forma de entrenamiento para modelos razonadores.
Identifico un fenómeno, ‘el dilema del inteligente’ que puede retrasar la adopción de la IA por parte de personas talentosas.
Presentamos la técnica de auto-refinamiento, una forma de conseguir que un gran modelo de lenguaje actúe como razonador.
Presentamos dos técnicas de prompting que ayudan a que un modelo razone, aunque supongan mayor coste computacional.
Se resumen unos hallazgos teóricos y experimentales que hablan de un tercer sistema cognitivo artificial y el riesgo de rendición cognitiva.
Comentamos las tres estrategias básicas para hacer que hacemos que un modelo razone, pasando de la generación de texto a planes.
Expreso mi opinión sobre la reciente publicación de Darío Amodei sobre los riesgos de los modelos frontera y cómo afrontarlos.

Revisamos algunas limitaciones en los modelos razonadores que encontró un equipo de Apple en un estudio de hace unos meses.
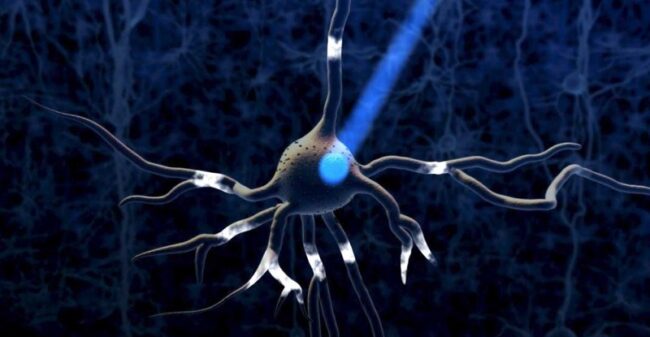
Describimos la técnica denominada optogenética holográfica con capacidad para actuar sobre el cerebro, con sus posibilidades y riesgos.
Hablamos de neurotecnología, neuroderechos y las cinco grandes áreas reconocidas actualmente de los neuroderechos.