Con este post llegamos al cuarto de la serie dedicada a cómo conseguimos un modelo razonador a partir de un gran modelo de lenguaje siguiendo las aportaciones del libro ‘Building a resoning model (from scratch)‘ de Sebastian Raschka.
En esta entrega, damos un viraje importante.
En los tres posts anteriores vimos formas de conseguir que un modelo razone, pero sin cambiar el modelo en sí mismo, es decir, sin cambiar sus pesos o sus hiperparámetros. O dicho de otra manera, no reentrenamos al modelo sino que éste continua siendo el que era antes de que intentásemos que razonase.
Sin embargo, en este artículo y el siguiente (que cerrará la serie), vamos a ver dos técnicas que sí reentrenan el modelo (hacen lo que se conoce como ‘fine tunning‘) y utilizan estrategias de aprendizaje por refuerzo.
Veamos.
La idea del ‘fine-tunning’
Aunque asumo que parte de los lectores habituales de este blog ya conocen el significado del ‘fine-tunning‘, y aunque, incluso, la recordé brevemente en el post que abría esta serie y en que hablaba de estrategias generales, vuelvo a aportar aquí unas pinceladas para refrescar conceptos y estar todos en la misma página, que se suele decir.
El ajuste fino o ‘fine-tuning‘ es una forma de entrenamiento (o, más bien, una fase de entrenamiento) en que se parte de un modelo ya entrenado y se le somete a un segundo entrenamiento más acotado para especializarlo en un dominio concreto o una tarea concreta.
La idea es que el modelo de partida, mediante lo que se denomina el ‘pre-entrenamiento’, adquiere conocimientos digamos generales. Conocimientos sobre el lenguaje en general y sobre la vasta variedad del conocer humano. Se trata de un entrenamiento masivo, con una enorme cantidad de datos, un gasto computacional extraordinario y, por tanto, al alcance de muy pocas organizaciones.
El ‘fine-tunning’, por el contrario, no es de propósito general, sino específico y ‘la gracia’ que tiene es que con un conjunto relativamente reducido de datos de entrenamiento y un gasto computacional moderado o pequeño suele conseguir muy buenos resultados en esa tarea o dominio específico. Por tanto, está al alcance de muchas empresas y organizaciones.
Ese ajuste fino o ‘fine-tunning’ se ha realizado con frecuencia mediante aprendizaje supervisado pero, en lo que vamos a ver en este post y en el siguiente, se aplica el aprendizaje por refuerzo.
Aprendizaje por refuerzo
Hace ya casi año y medio dediqué en este blog una larga serie de artículos, bastante técnicos, eso sí, a hablar del aprendizaje por refuerzo (‘reinforcement-learning‘). Para el lector interesado, le remito al último post de la serie dedicado al meta aprendizaje y que contiene enlaces a todos los demás artículos de la serie.
Aquí sólo recordar las ideas de muy alto nivel.
El aprendizaje por refuerzo es como la tercera gran vía del aprendizaje en machine learning (acompañando al aprendizaje supervisado y ni supervisado) y que, de alguna forma, quiere imitar la forma en que normalmente parece que aprendemos los humanos y que es un poco por ensayo y error.
Durante el entrenamiento por refuerzo el modelo recibe una entrada, genera una salida y recibe una forma de ‘feedback’ que le indica hasta qué punto lo está haciendo bien o mal. Suelo compararlo al juego del ‘frio’ o ‘caliente’. Con base a ese ‘feedback’ (habitualmente denominado ‘recompensa‘), el modelo ajusta sus parámetros (típicamente los pesos de una red neuronal).
Se diferencia del aprendizaje supervisado es que, en el aprendizaje supervisado durante el entrenamiento se le dice al modelo cuál es la respuesta correcta, mientras que en el aprendizaje por refuerzo sólo se le da una indicación de lo bien o mal que lo hace, pero sin decirle cuál es la respuesta correcta.
Y se diferencia del aprendizaje no supervisado es que en éste, el no supervisado, el modelo debe descubrir patrones subyacentes en los datos sin ninguna forma de ‘feedback’ explícito, mientras que ya hemos visto que en aprendizaje por refuerzo sí hay feedback (la recompensa).
Modelos razonadores y aprendizaje por refuerzo basado en recompensas verificables (RLVR)
En la referencia que estamos usando, nos subdivide el uso de aprendizaje por refuerzo en dos variantes. La primera, y la que vamos a mencionar en este post, es la que utiliza recompensas verificables.
¿Qué significa eso?
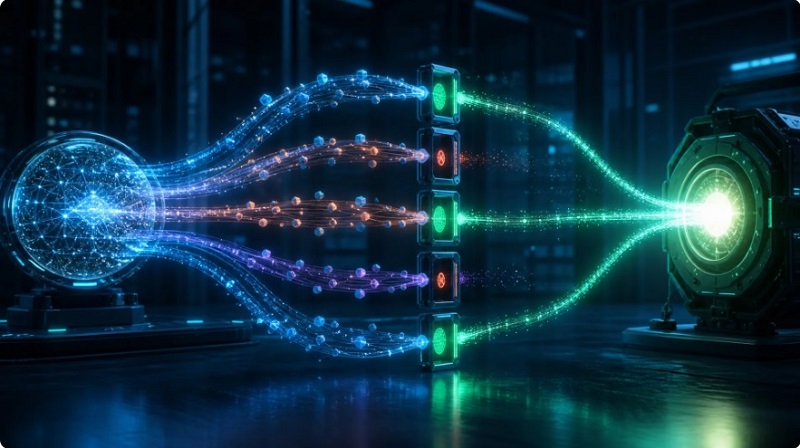
Significa que existe alguna forma objetiva de saber qué resultado final debería haber aportado el modelo y esa respuesta objetivamente correcta se utiliza para el feedback, la recompensa, que, por tanto, es verificable de forma objetiva.
Una forma fácil de visualizarlo es tener en cuenta que en el entrenamiento de modelos razonadores se usan con mucha frecuencia problemas lógicos o matemáticos con una respuesta final muy clara (verificable). Por tanto, el mecanismo para producir la recompensa que recibe el modelo podría llegar a ser el algún caso sencillo poco más que una calculadora digital.
Esto es lo que se denomina aprendizaje por refuerzo con recompensas verificables (RLVR, ‘Reinforcement Learning with Verifiable Rewards‘).
Una de las grandes ventajas de esta forma de entrenar por refuerzo frente a una genérica, es que el generador de recompensas, el verificador, no es otro modelo sino una herramienta mucho más sencilla (y, por tanto mucho más barata). Además, las recompensas son deterministas y reproducibles y la estrategia escala fácilmente a un entrenamiento con muchos datos si es necesario.
A cambio, una importante limitación es que no se puede aplicar esta estrategia al entrenamiento para razonar sobre cualquier tipo de problemas dado que, en muchos casos, no podemos disponer de esas reglas verificables. Por ello, se suele circunscribir, como hemos mencionado, a problemas lógicos o matemáticos.
No voy a entrar en detalles pero sí mencionar que RLVR se suele utilizar en conjunción con un algoritmo denominado GRPO (‘Group Relative Policy Optimization‘), introducido por el equipo de DeepSeek, que, a partir de la señal que genera RLVR, determina cómo usarla para la actualización de pesos del modelo.
Conclusiones
Hemos visto que podemos conseguir convertir un modelo razonador a partir de un gran modelo de lenguaje usando, no sólo técnicas de promting, como habíamos revisado en posts anteriores de esta serie, sino también haciendo un ‘fine-tunning’ mediante estrategia de aprendizaje por refuerzo.
Una de las variantes empleadas de aprendizaje por refuerzo es la que se basa en las denominadas recompensas verificables, en que un algoritmo, que no tiene por qué ser un modelo de lenguaje, es capaz de proporcionar de manera automatizada la señal de recompensa o ‘feedback’ y, mediante técnicas como GRPO, deducir la forma de actualizar los pesos del modelo.