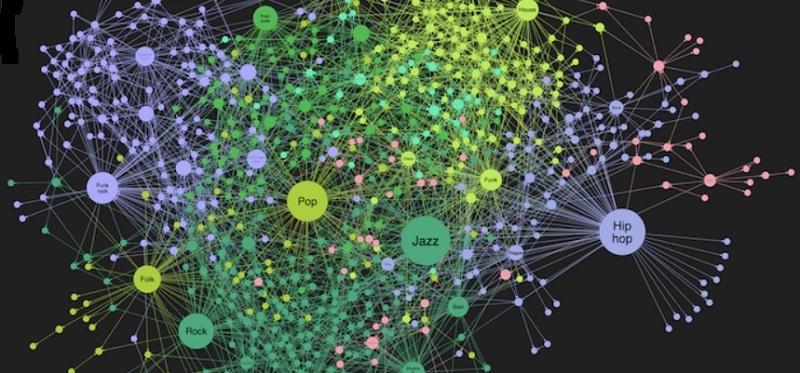
Los grafos son un recurso matemático e informático descritos y utilizados desde hace muchísimos años, tanto como forma de recoger información y ontologías, como para el guiado de ciertos algoritmos.
Los grafos han estado ahí y se han seguido explicando y utilizando durante años y años y así hasta hasta la actualidad.
Pero en estos momentos están ganando una enorme relevancia en lo que viene a ser la punta de lanza tecnológica actual: los agentes de inteligencia artificial.
Grafos: recordatorio muy básico
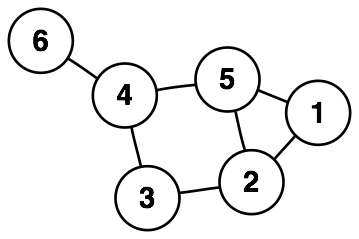
Aunque asumo que la mayoría de los lectores de este blog conocen, al menos aproximadamente, lo que es un grafo, lo recuerdo brevemente: un grafo es un formalismo para representar entidades o conceptos y las relaciones entre ellos.
Desde un punto de vista visual, los grafos constan de unos nodos que representan las entidades o conceptos y que se suelen representar como círculos, y de unos arcos o aristas (‘edges‘) que representan las relaciones entre los nodos y que se suelen representar como líneas.
Existen grafos dirigidos en que existe alguna forma de orden en las relaciones entre los nodos, y grafos no dirigidos en que no existe ningún tipo de orden en las relaciones. A la hora de representarlos gráficamente, los arcos terminan en una punta de flecha indicando la dirección.
Las memorias externas en agentes y chatbots generativos
Las aplicaciones basadas en grandes modelos de lenguaje, y particularmente los agentes de IA, deben utilizar mecanismos para volcar y/o recuperar información: las memorias. Esa información puede ser generada por el propio agente durante su trabajo (y en ese sentido, el nombre de memoria alcanza su plena significación) o, en otros casos, es información externa, una base de conocimiento o fuente de conocimiento.
Este tipo de aplicaciones utilizan varios mecanismos técnicos para implementar esas memorias (algo de lo que quizá valga la pena que comente en este blog) pero, cuando hablamos de bases de conocimiento, la técnica reina es RAG (‘Retrieval Augmented Generation‘).
Bases de datos vectoriales y RAG
RAG utiliza dos elementos técnicos relevantes.
Por un lado, tenemos una capacidad fundamental de los sistemas generativos, que consiste en generar para tokens, documentos, etcétera lo que se denominan ‘embeddings‘, unos vectores de alta dimensión que, de manera indirecta, contienen información semántica. Digo indirecta porque no es que marquen realmente un significado estricto y ‘anclado (‘grounded‘), pero sí la cercanía o lejanía semántica entre aquellos conceptos que representan.
Por otro, tenemos las bases de datos vectoriales un tipo de base de datos NoSQL especializada en trabajar, precisamente, con vectores, y que es donde se almacenan y recuperan los ‘embeddings‘.
Cuando queremos añadir, por ejemplo, un documento PDF a una base de conocimiento, éste se trocea (en los denominados ‘chunks‘) y para cada ‘chunk‘ se genera su ‘embedding‘. Estos ‘embedings‘ se almacenan en una base de datos vectorial.
Cuando queremos recuperar conocimiento ligado a alguna temática (con frecuencia expresada como ‘prompt‘), creamos un ‘embedding‘ que represente ese ‘prompt‘ y buscamos en la base de datos vectoriales, los vectores que sean ‘cercanos semánticamente’. Para cada uno de esos ‘embeddings‘ recuperados se accede a su ‘chunk‘ y ¡voila! ya tenemos conocimiento relacionado con lo que nos interesa
Las limitaciones de RAG
En el libro ‘Agentic GraphRAG: Integrating Knowledge Graphs, Reasoning, and Agency for Enterprise AI‘ de Anthony Alcaraz y Sam Julien se nos explica que RAG funciona muy bien para recuperación de información ligada a una consulta pero que, sin embargo, no funciona tan bien cuando de lo que se trata es de trabajar con razonamientos complejos y datos densos o especializados.
Y, precisamente, ese razonamiento complejo es lo que esperamos que hagan muchos agentes.
Los autores, concretando más, nos señalan las siguientes limitaciones de RAG:
- Gaps semánticos: En ocasiones la representación semántica mediante ‘embeddings‘ de un texto (un ‘chunk’) no siempre está suficientemente cercana al ‘embedding‘ de la consulta pese a que, objetivamente, el verdadero conocimiento necesario sí está en el texto original
- Compromisos de granularidad: Es necesario adoptar compromisos entre la cantidad de información o el nivel de información que representamos en un ‘embedding’, típicamente, si actuar en el nivel documento completo o en el nivel ‘chunk’ e, incluso, el tamaño de esos ‘chunks’. Según la decisión de granularidad adoptada, el comportamiento puede resultar mejor o no en ciertos casos.
- Limitaciones en razonamiento: El razonamiento suele requerir coordinar varios conocimientos o contenidos que pueden estar contenidos en ‘chunks’ diferentes y representados por ‘embedding’ diferentes. Eso complica el acceso al conocimiento necesario y no siempre funciona correctamente.
- Amnesia contextual: En general la representación mediante vectores es estática y sin ningún tipo de referencia temporal. Los ‘embeddings‘ están congelados y si se produce una evolución, pero los vectores originales siguen en la base de datos, el agente puede encontrarse con información obsoleta.
- Gap de asociatividad: Los sistemas RAG no son capaces de expresar relaciones transitivas o construir cadenas lógicas cuando enlaza conocimientos contenidos en ‘chunks‘ diferentes.
Los grafos como alternativa
Ante este panorama, están ganando fuerza los grafos, y en concreto los denominados grafos de conocimiento (‘Knowledge Graphs‘), como alternativa o complemento de los sistemas RAG.
Los grafos son capaces de aportar esa interrelación entre conceptos, esas relaciones transitivas, esa perspectiva evolutiva o temporal, etc que los agentes necesitan y que no encuentran bien resueltas en RAG.
Por ello, al auge de los agentes, le está acompañando el auge de los grafos de conocimiento. No voy a profundizar más ahora pero, en próximos posts, hablaré algo más de estos grafos de conocimiento y su uso en agentes y aplicaciones basadas en modelos frontera.
Los grafos como representación del conocimiento
No me resisto, no obstante, antes de finalizar el artículo, a hacer referencia a mi artículo anterior ‘El retorno de la representación de conocimiento‘ en que hablaba de cómo una disciplina muy presente en la inteligencia artificial clásica, es decir en la inteligencia artificial simbólica, como era la representación del conocimiento, se había perdido con la expansión de la inteligencia artificial basada en datos (‘machine learning‘) y especialmente el enfoque conexionista (‘deep learning‘) estaba experimentando un cierto resurgir.
Pues bien, quizá el exponente más relevante, aunque aún emergente, de ese retorno de la representación del conocimiento, sean estos grafos, como de alguna forma ya transmiten en su propio nombre: grafos de conocimiento.
Conclusiones
La explosión de la inteligencia artificial agéntica, está implicando el recuperar planteamientos anteriores para dotarles de conocimiento y contexto. Eso supone el retorno de la representación del conocimiento y, en particular, al auge de los gafos de conocimiento.