Quizá por mi experiencia de primera mano con software tradicional, siempre me ha parecido una labor muy difícil la prueba y evaluación de un modelo generativo, digamos un LLM, tanto del modelo en sí mismo, como de las aplicaciones que se construyen a su alrededor, típicamente un chatbot o un agente.
Y me parece difícil porque, por un lado, los casos posibles (que tradicionalmente se traducirían en casos de prueba) son virtualmente infinitos y porque, además, salvo en ciertos casos, no existe claramente una respuesta acertada o desacertada contra la que comparar.
Aunque en muchos de los libros de carácter técnico que he leído en los últimos meses y años se menciona el tema de la prueba y evaluación, me ha llamado la atención recientemente el desarrollo que ofrece el libro libro ‘Building a resoning model (from scratch)‘ de Sebastian Raschka, sobre todo porque lo explica de una manera, no sólo detallada, sino también muy bien estructurada.
Vamos a repasar brevemente, los métodos que identifica el autor.
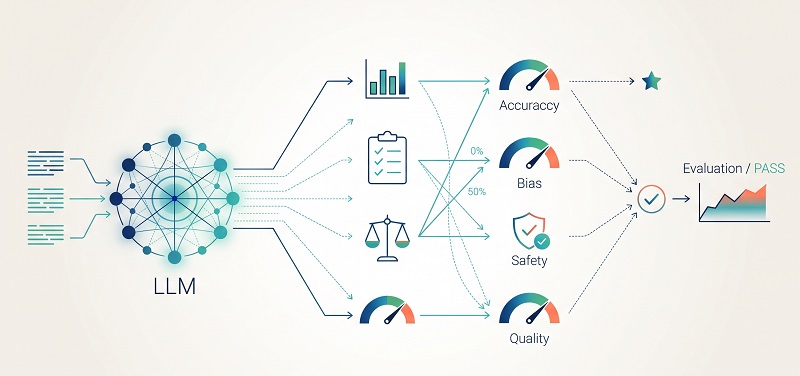
Los cuatro métodos de evaluación de modelos LLM
Se nos mencionan cuatro mecanismos, a saber:
- Respuesta múltiple (‘multiple choice‘)
- Verificadores (‘verifiers‘)
- Clasificaciones (‘leaderboards‘)
- LLMs como juez (‘LLM as a judge‘)
A su vez, estos cuatro métodos se pueden reducir a dos enfoques fundamentales: los métodos basados en ‘benchmarks‘ (comparativas) y los basados en juicio (‘judgement‘).
Los ‘benchmarks‘ permiten obtener métricas sencillas como la precisión comparando el ajuste de la respuesta proporcionada por el modelo con la que se considera correcta.
Los basados en juicio, por su parte, dan una valoración global de la respuesta, sin buscar exactamente un acierto.
Respuesta múltiple (‘multiple choice‘)
Este método es, realmente, el mismo que aplicamos en tantos y tantos cuestionarios o exámenes de tipo test: sometemos al modelo a una pregunta con varias posibles respuestas, una de las cuales es cierta, y analizamos si el modelo ha respondido correctamente.
En este línea se sitúan métodos como MMLU (‘Massive Multitasking Language Understanding‘) que incluye hasta 16.000 preguntas distribuidas en 57 materias. La puntuación, como no resulta sorprendente, consiste simplemente el porcentaje de respuestas correctas.
Se trata de una forma sencilla y precisa de evaluar, pero quizá sea limitada en cuanto a lo que está evaluando. Así, por ejemplo, no es un buen método para verificar las capacidades de razonamiento de un modelo razonador o la calidad de su respuesta en texto libre.
Por si solo, este mecanismo, pues, no garantiza del todo la bondad de un modelo pero, sin embargo, en el caso de una puntuación baja sí puede resultar un buen indicador de falta de calidad del modelo
Verificadores (‘verifiers‘)
Aunque se parecen al anterior sí que permite una respuesta del modelo en texto libre.
De la respuesta proporcionada, se extrae la parte relevante y se somete a un verificador externo. Por ejemplo, para un problema matemático, el verificador podría ser una calculadora.
Dado que este método permite un número ilimitado de problemas a resolver y que se beneficia de la ejecución paso a paso, se adapta muy bien a evaluar modelos razonadores. Eso sí, está limitado a tareas para las cuales se puede disponer de ese verificador, típicamente problemas de tipo matemático o lógico.
Clasificaciones (‘leaderboards‘)
Los dos métodos anteriores permiten, como ya apuntamos, obtener métricas de forma relativamente sencilla. Sin embargo, su evaluación es muy acotada y no permiten, por ejemplo, evaluar aspectos más holísticos como el estilo de la respuesta.
En el caso de los ‘leaderboards‘, no obtenemos realmente una métrica concreta, sino que los modelos son valorados por usuarios de manera global, en función de sus salida. Uno de los ‘leaderboards‘ más populares es Arena, en que los usuarios reciben dos respuestas, procedentes de modelos diferentes, y eligen la que consideran mejor. Recopilando y agregando muchas respuestas, se obtiene una valoración final de los modelos.
LLM como juez (‘LLM as a judge‘)
Se parece en cierto modo al caso anterior pero, ahora, quien evalúa no es un ser humano sino otro modelo.
A este modelo que actúa como ‘juez’ se le instruye de alguna forma en la manera de evaluar proporcionándole una rúbrica. Por supuesto, este método precisa de que el modelo que actúe como juez sea un modelo fuerte, de alta calidad.
Conclusiones
Vistos los cuatro métodos expuestos, observamos que, en efecto, tenemos mecanismos para probar un modelo, incluyendo un modelo razonador.
En conjunto, me parece que bien usados estos métodos permiten una buena evaluación de la calidad general del modelo y para la mayoría de los usos (especialmente a través de un chatbot) los entiendo suficientes.
No me tranquiliza del todo, sin embargo, o al menos observo carencias, si pensamos en protegernos ante errores, muy especialmente, pensando en modelos usados como cerebro de agentes con alta autonomía y capacidades importantes de actuación.
O, si se prefiere, quizá estos métodos sean suficientes para lo que es el modelo en sí mismo, pero se necesitan más pruebas, y probablemente de otro tipo, para garantizar la seguridad y confiabilidad de agentes en su conjunto, tanto desde un punto de vista de prevención de ataques adversarios como de errores o derivas catastróficas.